即使解开了难题,也无法判断是不是真正的专家了
数学界的诺贝尔奖——菲尔兹奖25位得主的宣言,与咨询市场31%的数据,正在讲述同一个故事
商业宣言中出现了“代理指标”这个词
2026年9月11日,25位菲尔兹奖得主在一份联合宣言上署名。宣言的内容是:AI企业把破解数学难题当作性能指标的做法,与数学这门学科的目标严重背离。从1978年得主皮埃尔·德利涅(Pierre Deligne)到2026年得主Wi Deng(音译),横跨了好几代人,韩裔数学家June Huh教授的名字也在名单中。
宣言的核心不是批判,而是一句定义。这句话说的是:解题只是一种工具,一个用来衡量是否达到概念理解这一真正目标的代理指标1。如果把工具误认为目标,工具就会伤害目标本身。
两天后,截至9月13日,签署人数已增至4,432人。签署页面要求通过ORCID登录或所属机构邮箱验证,才能把名字列进去。就连这份宣称代理指标已经崩溃的文件本身,也另外设置了确认签署者是否是真正研究者的装置。
我没有把这份宣言只当作数学界内部的事件来读。因为我早已在其他市场看到过同样的故障。
难题曾是数学界的测量工具
数学中著名的难题一直在同时做两件事。一件是对内的事。难题被解开,就是一个信号,说明在这个过程中诞生了新的方法和概念,数学家们通过发表、讨论和整理,把这些想法变成了公共工具。
另一件是对外的事。即便我说不清伽罗瓦表示是什么,我也知道费马大定理已经被证明。难题是一把刻度尺,让不懂数学的人也能看出一个人的实力。
宣言真正质疑的,不是AI破解难题这件事本身,而是解题过程被仓促公开,导致正规的整理、对先行研究的引用、把想法拆解打磨的过程统统缺失。签署者写道,由此产生了归属和抄袭方面的问题。结果出来了,但如果理解并接续这个结果的人消失了,刻度尺留了下来,刻度尺本来要测量的东西却没有了。
简单来说,数学家们所说的危险,是指如果反复跳过中间过程、只顾抓住答案,数学的本质和原理就会变得模糊。
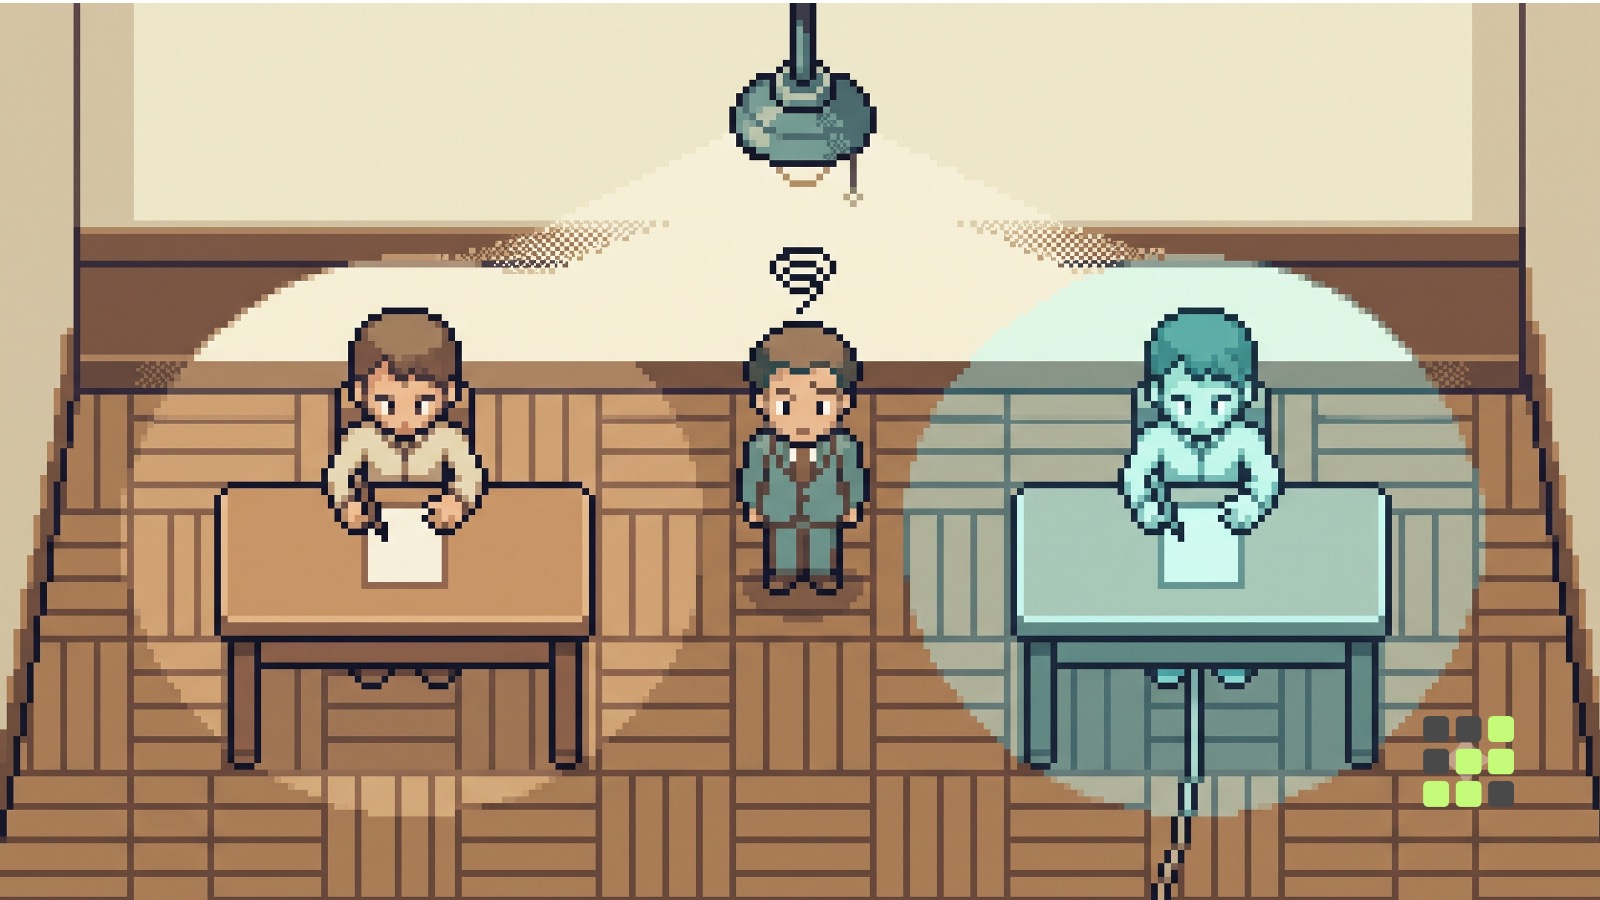
举例来说,如果有一道数学题答案是-1、0、1三者之一,那么蒙对的概率是33.3%,但真正有实力解开这道题的学生会用公式和论述来求解,而有些人则会靠瞎蒙单选来作答。如果AI式的解题方式大行其道,以后还有谁会去学数学呢?
数学只是这件事表现得最明显的地方。在早已被标好价格的市场里,裂痕其实很久以前就已经出现了。
咨询市场本来就是靠自我申报运转的
有一个叫做专家网络2的市场。投资公司和咨询公司在这里购买某个行业从业者一小时的电话咨询。GuidePoint 表示其专家库超过 200 万人,GLG 则表示拥有超过 100 万人的专家库。
2025 年 12 月 4 日,一家研究这个行业的调研公司发布了对 1,368 名参与咨询的专家进行问卷调查的结果。约 31% 的受访者表示,自己曾参与过并非自身专长领域的电话咨询。1,368 人中约 420 人。报告指出了三个原因:专业性由本人自行申报、必须在 24~48 小时内完成需求匹配的交期,以及依靠关键词进行人选匹配。
这里有一点值得停下来看看。**在造成资质不符通话的原因清单里,AI 根本不在其中。**验证机制本来就是依赖自我申报,并不是被 AI 破坏掉的。同一项调查显示,客户每单支付 1,200 美元,而专家拿到的分成不到收费金额的 20%,这中间的差额,从购买方的角度看,正是为验证支付的成本。由于这是针对行业参与者的自我作答问卷,具体数字应当宽泛地看待,但方向本身没有理由被怀疑。
专家网络在通话前后运行的合规程序相当严密。但那是用来防止未公开重大信息被泄露的装置,并不是用来核实这个人在那段时期是否真的做过那份工作、现在所说的是否是本人的判断的装置。
<<<OZ_BODY>>>
买方和卖方都在同时向模型转变
从需求端来看,变化更快。GuidePoint 宣布,截至 2026 年 3 月 26 日,专家访谈录音记录已突破 10 万份,5 月 5 日又通过 MCP3 将该资料库接入 Claude。8 月 26 日,又有 12 万份以上的记录被连接到 Gemini Enterprise。由于每月新增 5,000 份的结构,这个规模只会随时间越滚越大。AlphaSense 和 Tegus 宣布,由 AI 代替真人主持的专家通话,比原来便宜 70%,GLG 也提供由 AI 主持的通话服务。
向人提问得到的答案变成了录音记录,录音记录成为模型的输入数据,而下一次提问的对象从人变成了模型。曾经一次性买下的一个小时,正在变成可以反复出售的资产。
价格会往哪个方向走,也不难猜测。对于已积累的录音记录就能回答的问题,已经没有理由再花钱购买通话,于是常见问题的通话单价开始下降。反过来,资料库里没有的问题——也就是还没有任何人留下记录的判断——则会被标上价格。这不是各公司公开宣布的事实,而是我根据目前的结构做出的推测。
供给端也在朝同一个方向移动。相当一部分咨询是以书面形式往来的,而这恰恰是模型最擅长作答的形式。即便换成视频通话,情况也不会有太大不同。于是买方很难分辨自己买到的究竟是人还是模型,卖方也没有恰当的方法证明自己是真人。尽管双方都因此蒙受损失,交易却依然照常发生。
那么能证明什么
走到这一步,剩下的答案只有一个。不是正确答案,而是亲身经历过的事。可是要认证经验,方法却相当模糊。分成三层来看,就能看出哪里是空的。
| 层级 | 能证明什么 | 谁来确认 |
|---|---|---|
| 归属与年限 | 在哪里待过几年 | 公司、学校、机构 |
| 判断的记录 | 何时决定了什么,什么地方判断失误 | 目前只有本人 |
| 成果的归属 | 那项成果是否源于我的判断 | 没有确认体系 |
第一行能被确认,但说明不了实力。第三行能说明实力,却无法被确认。所以真正的检验,就在第二行分出胜负。对研究者而言,ORCID 和引用记录能填补这个空位,但对实务工作者来说,并没有这样的东西。
**同样的原理,在咨询通话之外也照样成立。**履历、提案书、作品集、面试回答,全都是代理指标,如今光靠“做得漂亮”已经无法筛选出任何东西了。写得好的文件曾是实力的证据——那个时代已经短暂地结束了。像韩国这样,习惯用书面资料和一次性发表来评价一个人的市场,会更直接地迎面撞上这场变化。
如果你是购买方,改变提问的方式是成本最低的应对办法。市场展望或结构说明,模型给出的更快,也往往更准确。但只要问对方在当时反对过的决定、失败的案例、以及事后据此修改的标准、还有此刻这个答案里最可能出错的部分,答案的性质就会不一样。因为在特定时刻以自己的名字押上去做出的选择及其代价,是搜索不出来的。如果你是出售方,把那份选择和代价以带有时间戳的形式留存下来,本身就会成为一种资产。
也有人把这份宣言解读为“红旗法”
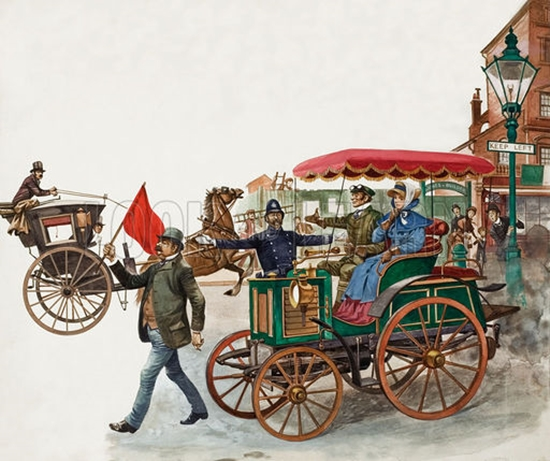
也出现了相反的解读。1865 年,英国制定法律,要求汽车前方须有人举着红旗步行引导。这被称为马车行业阻碍新技术发展速度的典型案例。菲尔兹奖得主们的宣言,说到底也是即将失去地位的一方的抗议——这是一种解读方式。此外还有一种主张认为,解数学题今后会像下棋一样,沦为一种智力游戏。
时间点也值得关注。2002 年,一位名叫 Paul Lockhart 的数学教师写了一篇题为《一个数学家的叹息》的文章。他写道,学校数学剔除了发现的过程,只留下了结果。三角形面积等于底乘高的一半,这一事实本身不是数学,得出这一事实的那一句话式的想法才是数学,而学校只是让学生死记公式,就此了事。他的结论是:数学课上没有数学。**同样的抱怨在 24 年前就已经存在,而当时的对手不是 AI,而是数学界自己制定的课程体系。**这也是为什么很难把这份宣言看作是新技术出现后仓促拿出的防御姿态。
不过,一旦搬出 Lockhart,数学界这边也讨不到好处。 我自己也是因此,在创办咨询公司时第一件做的事,就是宣布不再出售报告。反正报告人工智能很快就能写出来。不如把这个时间用来搭建可运行的 PoC/MVP,或者开展工作坊,这样更有价值。
而游戏论这一方,反而是在为这篇文章的论点撑腰。 人们花钱看的是比电脑弱的棋手之间的对局。所谓解题会沦为游戏,意味着它当场就会失去实力证明的功能,而这正是代理指标消失的过程。唯一的区别在于,咨询市场里没有人会为“观赏”买单。
Oswarld视角
我在 他们说自从 LLM 普及之后,几乎没有办法区分专家了。书面咨询会被 AI 代答,即便改用视频进行,也有很多能实时作答的前沿模型,这确实是事实。
所以现在验证专家的方式只剩下经验这一条,而我一直卡在如何认证这份经验这一点上。我在哪家公司待了多久是可以核实的,但当时做出了怎样的判断、那个判断是否正确,除了我自己的话之外没有任何依据。除了自己动手填写上表第二行之外,我还没找到眼下能用的其他手段。
有一点看起来很清楚:菲尔兹奖得主们想要守护的东西,和顾问负责人所苦恼的问题,本质上是同一类问题。两者都不是在丧失对成果品质的判断力,而是正在丧失识别成果背后那个人的能力。只不过数学界已经有论文、引用和所属机构这样的验证装置,而实务专家市场上却只有自我申报这一条路。所以我认为,这个市场会更早、也更悄无声息地崩塌。
结语
代理指标本来就是用来替代衡量实力的临时工具。解题、写好书面回答、流畅地讲解,都属于这一类。如今模型接管了这个临时工具,剩下的就是一个人经历过什么、在那时做出了怎样的选择。问题在于,我们还没有一套体系能够证明这一点。
如果读者您正处于需要判断某人专业能力的位置上,那么现阶段比起答案本身的质量,问对方答案是怎么得出来的会更保险一些。被这个问题问住的人是否真的越来越多,我也会继续观察下去。
💬 最近您在判断某人的专业能力时,是看什么来做决定的?如果有哪个标准失灵了,我也很想知道。
📨 如果您身边有同事需要请教顾问或外部专家,请把这篇文章转发给他们。哪怕只是换掉提问清单,也能马上派上用场。


参考资料与延伸阅读
核心来源
- Math and AI,“A Severe Misalignment of AI in Mathematics”,2026 年 9 月 11 日。……声明原文、25 名首批签署人名单、签署程序都在同一页上
- Terence Tao,“A Severe Misalignment of AI in Mathematics”,What’s new,2026 年 9 月 11 日。……附有签署人本人对声明形成过程的简短说明
- Woozle Research,“The State of the Expert Economy 2025”,2025 年 12 月 4 日。……给出了资格不足回答占 31% 这一数据的分母范围和原因分析
- Guidepoint,“Guidepoint Launches MCP on Claude”,2026 年 5 月 5 日。……公司亲自说明了专家通话录音如何成为模型输入的结构
背景知识
- GLG,“Expert Calls”。……可以确认合规流程审查什么、又不审查什么
- Paul Lockhart,“A Mathematician’s Lament”,2002。……这是一篇 25 页的原文。仅读完开头两页那个音乐教育噩梦式的开场,就能看出这次声明的根源
- Guidepoint,“Guidepoint Accelerates Enterprise AI Transformation with Gemini Enterprise”,2026 年 8 月 26 日。……可以比较录音规模在五个月间是如何扩大的